この記事でわかること
- 決定木の考え方と、使う場面・使わない場面
- ジニ不純度でどの要因から分けるかを決める計算(Excel対応)
- 分けすぎを防ぐ止め方と、ランダムフォレストとの違い
📌 前提知識:チェックシートと層別の使い方|QC七つ道具を読んでいると理解しやすくなります
射出成形の工程で、ショートやヒケの不良が出るロットと出ないロットがあります。日報には、金型温度、材料の乾燥時間、昼勤か夜勤か、といった条件が40ロット分残っています。どの条件が不良に効いているのか、表を眺めていても見えてきません。
条件ごとに層別すれば、1つずつは比べられます。ところが「温度が低いときだけ乾燥時間が効く」のように、条件の組み合わせで効き方が変わると、1つずつの層別では見落とします。こういうとき、データを条件で次々に2つに分けて、不良のそろったグループを探すのが決定木です。この記事では、Excelだけで追える小さな例で、決定木の中で何が計算されているかを確かめます。
決定木を使う場面
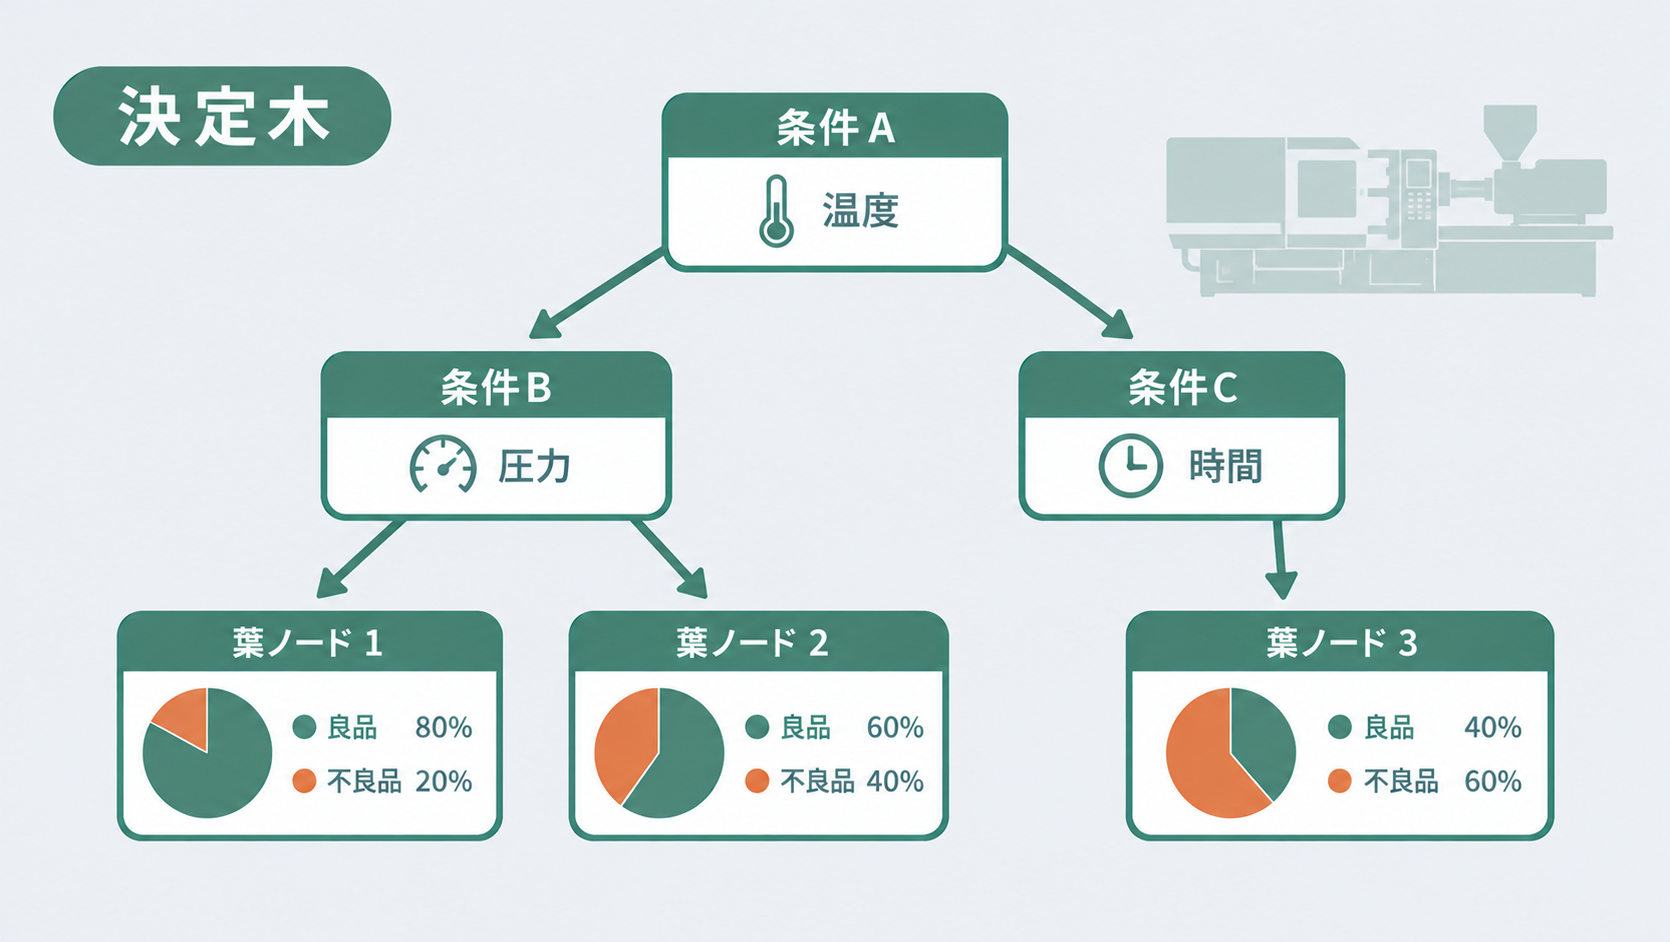
決定木は、結果(不良が出たか、出なかったか)と、それに関係しそうな条件が並んだデータから、「どの条件で分けると結果がはっきり分かれるか」を探す方法です。分け方が木の枝のように描けるので、決定木と呼ばれます。
- 日報や検査記録がたまっていて、不良の出る条件の当たりをつけたいとき
- 条件の組み合わせで効き方が変わりそう(交互作用がありそう)なとき
- 結果を「温度が○○未満で、乾燥が○時間未満なら要注意」のような、現場で使えるルールの形にしたいとき
一方で、向かない場面もあります。
- データが数十件しかないのに、条件の数が多いとき。偶然のばらつきで枝ができてしまいます
- 「温度を1℃上げると不良率が何%下がるか」のように、効き方の大きさを数字で知りたいとき。これはロジスティック回帰や回帰分析の役割です
- 原因を確定させたいとき。決定木が見つけるのは「一緒に起きている条件」で、原因かどうかは実験で確かめます
結果が良品・不良のような2値で、効き方を係数で見たいときはロジスティック回帰分析とは|2値データの予測とExcelでの推定が向いています。決定木は、それより前の「どこを見ればよいか」の段階で役に立ちます。
決定木の考え方|ジニ不純度で「混ざり具合」を測る
決定木は、データ全体を1つの箱に入れたところから始めます。箱の中には良品ロットと不良ロットが混ざっています。これを条件で2つの箱に分け、それぞれの箱の中ができるだけ「良品ばかり」か「不良ばかり」になる分け方を選びます。
「どれだけ混ざっているか」を測る物差しとして、よく使われるのがジニ不純度です。箱の中の不良の割合を \( p \) とすると、次の式で計算します。
\[ G = 1 – p^2 – (1-p)^2 = 2p(1-p) \]
不良ばかり(\( p=1 \))でも良品ばかり(\( p=0 \))でも \( G=0 \) で、半々(\( p=0.5 \))のとき最大で0.5です。Excelでは、不良の割合がB2セルにあれば次の式です。
=1-B2^2-(1-B2)^2
2つの箱に分けたあとの混ざり具合は、箱の大きさで重みを付けた平均で表します。左の箱が \( n_L \) 個、右の箱が \( n_R \) 個、全体が \( n \) 個なら、次のとおりです。
\[ G_{分割後} = \frac{n_L}{n} G_L + \frac{n_R}{n} G_R \]
Excelでは、ロット数とジニ不純度を並べて =(C2*D2+C3*D3)/(C2+C3) のように計算します(C列がロット数、D列がジニ不純度)。分ける前のジニ不純度から、分けたあとの値を引いた「減少量」がいちばん大きい条件を選びます。これを、分けられなくなるまで繰り返すのが決定木の手順です。
例題|射出成形40ロットの不良を分ける
ある射出成形の工程で、40ロットの記録を集めました。条件は次の3つで、どれも2つに分けた値で記録しています。
| 条件 | 分け方 |
|---|---|
| 金型温度 | 低(180℃未満)/高(180℃以上) |
| 材料の乾燥時間 | 短(3時間未満)/長(3時間以上) |
| シフト | 夜勤/昼勤 |
40ロットのうち12ロットで不良が出ました。不良の割合は \( p = 12/40 = 0.30 \) で、全体のジニ不純度は \( 2 \times 0.30 \times 0.70 = 0.42 \) です。
手順1:3つの条件で分けてみる
3つの条件のそれぞれで2つに分け、分けたあとのジニ不純度を比べます。
| 分け方 | 2つの箱(ロット数/不良) | 分けたあと(減少量) |
|---|---|---|
| 金型温度 | 低 16/10、高 24/2 | 0.2792(0.1408) |
| 乾燥時間 | 短 20/8、長 20/4 | 0.4000(0.0200) |
| シフト | 夜 18/6、昼 22/6 | 0.4182(0.0018) |
金型温度で分けた場合を計算してみます。「低」の箱は不良の割合が 10/16=0.625 で、ジニ不純度は \( 2 \times 0.625 \times 0.375 = 0.4688 \)。「高」の箱は 2/24=0.0833 で 0.1528 です。重みを付けた平均は \( (16 \times 0.4688 + 24 \times 0.1528) / 40 = 0.2792 \) で、0.42から0.1408下がりました。
減少量がいちばん大きいのは金型温度です。最初の枝は「金型温度が低いか高いか」に決まります。シフトで分けても、混ざり具合はほとんど変わりません。
手順2:分けた箱の中で、もう一度分ける
次は「低」と「高」の箱のそれぞれで、残りの条件(乾燥時間・シフト)を試します。
| 箱 | 分け方(ロット数/不良) | 減少量 |
|---|---|---|
| 温度「低」(16/10) | 乾燥 短 9/8、長 7/2 | 0.1791 |
| 温度「低」(16/10) | シフト 夜 8/5、昼 8/5 | 0 |
| 温度「高」(24/2) | 乾燥 短 11/0、長 13/2 | 0.0118 |
| 温度「高」(24/2) | シフト 夜 10/1、昼 14/1 | 0.0004 |
温度「低」の箱では、乾燥時間で分けると混ざり具合が0.4688から0.2897へ大きく下がります。乾燥時間が短いと9ロット中8ロットで不良が出ていて、ほぼ不良だけの箱になりました。温度「高」の箱は、もともと24ロット中2ロットしか不良がなく、どちらで分けてもほとんど下がりません。
手順3:止めどころを決める
決定木は、放っておくと最後は1ロットずつの箱になるまで分け続けてしまいます。そこで、分ける前に止める決まりを置きます。この例では次の3つにしました。
- 深さ(枝分かれの段数)は2段まで
- 分けたあとの箱が5ロット未満になる分け方はしない
- 減少量が0.02未満なら分けない
温度「高」の箱は、乾燥時間で分けても減少量が0.0118なので分けません。温度「低」の中の箱も、ここで2段目なので止めます。
手順4:できあがった木を読む
| 最後の箱(葉) | ロット数/不良 | 不良の割合 |
|---|---|---|
| 温度 低・乾燥 短 | 9/8 | 88.9% |
| 温度 低・乾燥 長 | 7/2 | 28.6% |
| 温度 高 | 24/2 | 8.3% |
読み方は、上から順に条件をたどるだけです。「金型温度が低く、しかも乾燥時間が短いロット」は、9ロット中8ロットで不良を出しています。金型温度が高ければ、乾燥時間が短くても11ロットすべて良品でした。
ここで注目したいのは乾燥時間です。手順1で全体を乾燥時間だけで分けたときは、減少量が0.0200しかなく、ほとんど効かないように見えました。ところが温度「低」の中では、いちばん効く条件になっています。乾燥時間は「金型温度が低いときだけ効く」ということで、これは交互作用そのものです。決定木は、こうした条件の組み合わせを自然に拾います。交互作用の考え方は交互作用とは|主効果との違いと交互作用図の読み方で解説しています。
この木で「温度 低・乾燥 短なら不良が出る」と見なすと、40ロット中35ロットで当たり(87.5%)です。不良12ロットのうち8ロットをこの箱で捉え、良品を不良と見なしたのは1ロットでした。残りの不良4ロットは、ほかの箱に紛れています。
Excelでの計算手順
40ロットのデータを、A列にロット番号、B列に金型温度(低/高)、C列に乾燥時間(短/長)、D列にシフト(夜/昼)、E列に不良(出たら1、出なければ0)として2行目から41行目に並べます。
箱ごとのロット数と不良の割合
ロット数は COUNTIFS、不良の割合は AVERAGEIFS で求めます。E列が1と0なので、平均がそのまま不良の割合です。温度「低」の箱なら次のとおりです。
=COUNTIFS($B$2:$B$41,"低") → 16
=AVERAGEIFS($E$2:$E$41,$B$2:$B$41,"低") → 0.625
2段目の箱は、条件を足すだけです。温度「低」で乾燥「短」の箱なら次の式で、結果は 0.889 です。
=AVERAGEIFS($E$2:$E$41,$B$2:$B$41,"低",$C$2:$C$41,"短")
ジニ不純度と減少量
不良の割合からジニ不純度を出し、ロット数で重みを付けて平均します。表にすると次の形です。2行目が「低」の箱、3行目が「高」の箱で、3行目の式は “低” を “高” に、I2 を I3 に替えます。
| セル | 内容 | 式の例 |
|---|---|---|
| H2・H3 | 2つの箱のロット数 | =COUNTIFS($B$2:$B$41,"低") |
| I2・I3 | 不良の割合 | =AVERAGEIFS($E$2:$E$41,$B$2:$B$41,"低") |
| J2・J3 | ジニ不純度 | =2*I2*(1-I2) |
分けたあとのジニ不純度は =SUMPRODUCT(H2:H3,J2:J3)/SUM(H2:H3)、減少量は分ける前の値(全体なら0.42)からこれを引きます。条件ごとに同じ表を作り、減少量のいちばん大きい条件を選びます。
条件が3つで2段までなら、この手作業で十分に追えます。条件が10を超える、温度を「低/高」ではなく実際の値のまま使いたい、といった場合は、分け方の候補が一気に増えます。温度の値なら、並べ替えて隣どうしの中間の値をすべて境目の候補にして試すのが決定木のやり方で、手作業では追いきれません。そこから先は Python などの道具に任せます。Excel と Python の使い分けはPython統計解析入門|Excelとの使い分けと学び方にまとめています。
分けすぎに注意|止め方とランダムフォレスト
分けすぎるとどうなるか
手順3で止めた温度「低」・乾燥「長」の箱(7ロット中2ロットが不良)を、決まりを無視してシフトで分けてみます。夜勤3ロットは不良0、昼勤4ロットは不良2で、減少量は0.1224もあります。数字だけを見ると「昼勤が悪い」という枝が作れそうです。
しかし、3ロットと4ロットの違いです。手順2で見たとおり、温度「低」の箱全体ではシフトによる差はまったくありませんでした。ロット数の少ない箱ほど、偶然の偏りで大きな差が出ます。こうして手元のデータには合うのに、次のロットには当てはまらない木になることを「過学習」と呼びます。止める決まりを先に決めておくのは、これを防ぐためです。
ランダムフォレストとの違い
1本の決定木は、データが少し変わるだけで枝の形が変わりやすいという弱点があります。そこで、データから少しずつ違う標本を何百回も取り出して、そのたびに決定木を作り、多数決で答えを出す方法があります。これがランダムフォレストです。木をたくさん集めるので「森」と呼びます。
| 決定木 | ランダムフォレスト | |
|---|---|---|
| 結果の形 | 1本の木=現場で読めるルール | 数百本の多数決=ルールとしては読めない |
| 予測の精度 | データの揺れに弱い | 安定して高い |
| Excelでの計算 | 小さな例なら手で追える | 現実的ではない(Python などを使う) |
不良の要因の当たりをつけて、現場で対策の手順に落とすのが目的なら、読める決定木が向いています。読めなくてもよいから予測の当たる率を上げたいなら、ランダムフォレストを使います。
結果を使うときの注意点
- 決定木が示すのは「一緒に起きている条件」。例題で金型温度が効いているように見えても、実は温度が低い日は朝一番の立ち上げが多い、といった別の理由かもしれません。対策を決める前に、条件を変えた試し打ちで確かめます
- 元の記録に入っていない条件は見つからない。材料ロットや金型の番号を記録していなければ、木はそれを使えません。どの条件を記録するかは、特性要因図で要因を洗い出してから決めるのが確実です
- 止める決まりは分析の前に決める。結果を見てから「この枝は採用、この枝は不採用」と選ぶと、都合のよい木になってしまいます
要因を洗い出す段階は特性要因図とは|書き方のルールと作り方・記入例、見つけた要因を計画的な実験で確かめる段階は実験計画法とは?3原則と手法の選び方を例題で解説で解説しています。決定木は、この2つのあいだで「どこから確かめるか」を絞る道具です。
よくある質問
Q. 決定木と層別は何が違いますか?
A. 層別は、人が選んだ1つの条件でデータを分けて比べる方法です。決定木は、どの条件で分けるかをジニ不純度で自動的に選び、分けた箱の中でさらに分けることを繰り返します。条件の組み合わせで効き方が変わる場合に、層別では見落とすものを拾えます。
Q. ランダムフォレストとは何ですか?
A. データから少しずつ違う標本を何百回も取り出して決定木を作り、その多数決で答えを出す方法です。1本の決定木より予測は安定しますが、結果を1本のルールとして読むことはできません。
Q. 何件くらいのデータがあれば使えますか?
A. 決まった基準はありませんが、最後の箱にそれぞれ5件以上は残るくらいが目安です。条件の数が多いほど、偶然の枝ができやすくなるので、データもそれだけ多く要ります。
Q. ジニ不純度のほかに物差しはありますか?
A. エントロピーという物差しもよく使われます。計算の式は違いますが、選ばれる分け方はジニ不純度とほとんど同じになることが多いです。Excelで手計算するなら、式の簡単なジニ不純度が扱いやすいです。
📚 この記事の内容をもっと深く学ぶ
まとめ
- 決定木は、データを条件で2つに分けることを繰り返し、結果のそろった箱を作る方法
- どの条件で分けるかは、ジニ不純度 \( 2p(1-p) \) の減少量で決める。Excelでは AVERAGEIFS で不良の割合を出せば計算できる
- 例題では、金型温度で分けたあと、温度「低」の中で乾燥時間が効いた。全体では効かないように見えた条件が、組み合わせで効くことを拾える
- 分けすぎると偶然に合わせた木になる。深さ・箱の大きさ・減少量の止める決まりを先に決める
まとめると、要因の当たりをつけて現場で読めるルールにしたいなら決定木、予測の当たる率を上げたいならランダムフォレスト、効き方の大きさを数字で知りたいならロジスティック回帰、という使い分けです。まずは日報の条件を3つ選び、Excelで1段目の分け方を比べてみてください。
決定木を含む多変量解析の手法全体の選び方は多変量解析とは|手法の選び方と9種類を目的別に整理、分けた箱どうしの不良の割合に差があるかを検定で確かめる方法はカイ二乗検定(χ²検定)とは|独立性の検定と適合度検定をExcelで実践で解説しています。あわせてご確認ください。