この記事でわかること
- 検査を1個ずつ進めて途中で打ち切る判定の手順(Excel対応)
- 受入線・棄却線の式の求め方
- 固定サンプル方式と比べて何個減るか
- 逐次検定が向かない場面の見分け方
📌 前提知識:抜取検査とOC曲線を読んでいると理解しやすくなります
受入検査の抜取表を引いたら、サンプル数132個と出ました。破壊検査なので132個は捨てることになります。最初の40個が全部良品でも、残り92個を測り続けなければいけません。
検査を始めて10個目で不良が2個出た場合も同じです。このロットは通らないとほぼ分かっているのに、決められた個数まで検査を続ける決まりになっています。
逐次検定は、この「先に個数を決める」という縛りを外した方法です。1個検査するたびに判定を試み、結論が出た時点で打ち切ります。
逐次検定を使う場面
逐次検定(SPRT、逐次確率比検定)が効くのは、1個あたりの検査コストが高く、しかも検査を途中で止められる場面です。次の3つがあてはまります。
- 破壊検査や長時間の試験のとき。1個の判定に数時間かかる耐久試験では、打ち切れる個数がそのまま日数に効きます
- 検査結果が1個ずつ順番に出るとき。まとめて測る自動測定機ではなく、手作業で1個ずつ判定する検査に向きます
- ロットの良し悪しがはっきりしていることが多いとき。良いロットと悪いロットに分かれる工程ほど、早く判定がつきます
NG例(△)として、検査個数を先に確定させて計画を組む必要がある場合には使えません。逐次検定は終了個数が事前に決まらないため、「何個用意すればよいか」に答えられないからです。客先との取り決めでサンプル数を明記する受入検査も、この理由で対象外です。検査の種類でいえば、社内の工程内検査や信頼性試験のほうが相性がよい方法です。
判定の仕組み|尤度比を足していく
逐次検定は、検査するたびに「どちらの仮説のほうがもっともらしいか」の重みを加算していきます。用意するのは2つの不良率です。
- \( p_0 \):これなら合格にしたい不良率(今回は1%)
- \( p_1 \):これなら不合格にしたい不良率(今回は5%)
1個検査するごとに、対数尤度比を次のように足します。不良なら \( a \)、良品なら \( b \) を加算します。
\[ a = \ln\frac{p_1}{p_0}, \qquad b = \ln\frac{1-p_1}{1-p_0} \]
ExcelではLN関数がそのまま対応します。
=LN(0.05/0.01)      → 1.609438   (不良が1個出たときの加算量)
=LN(0.95/0.99)      → -0.041243  (良品1個あたりの加算量)
良品が出るとわずかに下がり、不良が出ると大きく跳ね上がる、という非対称な動きをします。この差が39倍あることが、後で出てくる判定のクセにつながります。
加算した合計を \( \Lambda_n \) と書きます。これが上の境界を超えたら不合格、下の境界を下回ったら合格、どちらでもなければ検査を続けます。境界は生産者危険 \( \alpha \) と消費者危険 \( \beta \) から決まります。
\[ \ln A = \ln\frac{1-\beta}{\alpha}, \qquad \ln B = \ln\frac{\beta}{1-\alpha} \]
Excelでは次のとおりです。\( \alpha = 0.05 \)、\( \beta = 0.10 \) として計算します。
=LN((1-0.1)/0.05)   → 2.890372   (上の境界=棄却)
=LN(0.1/(1-0.05))   → -2.251292  (下の境界=受入)
\( \alpha \) と \( \beta \) の意味は通常の検定と同じです。第1種の誤りと第2種の誤りで扱ったあわて者・ぼんやり者の誤りを、そのまま抜取検査の生産者危険・消費者危険に読み替えた形です。
例題|不良率1%と5%を見分ける
電子部品の受入検査を考えます。不良率1%までなら受け入れたい、5%あるなら突き返したい。生産者危険5%、消費者危険10%で設計します。
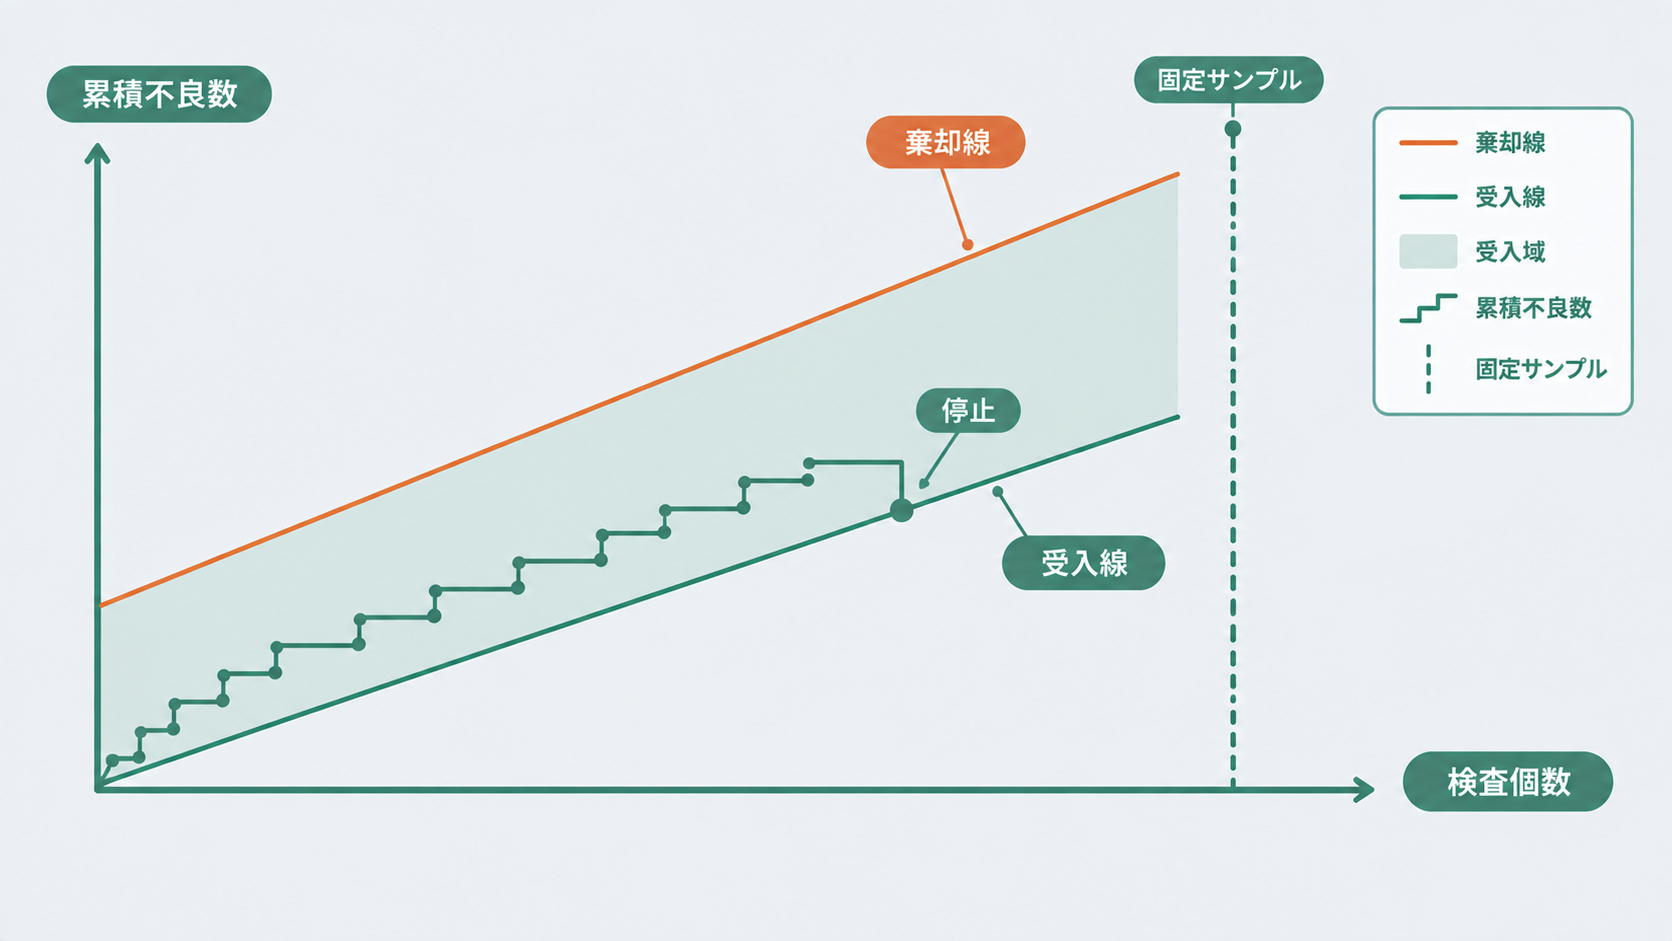
毎回 \( \Lambda_n \) を計算するのは面倒なので、累積不良数 \( d \) と検査個数 \( n \) の直線に直します。\( \Lambda_n = d\,a + (n-d)\,b \) を境界の式に代入して \( d \) について解くと、傾きの等しい2本の直線が出ます。
\[ d = s\,n + h, \qquad s = \frac{-b}{a-b} \]
傾き \( s \) と2本の切片をExcelで求めます。
=-LN(0.95/0.99)/(LN(0.05/0.01)-LN(0.95/0.99))   → 0.024985  (共通の傾き)
=LN(0.1/(1-0.05))/(LN(0.05/0.01)-LN(0.95/0.99)) → -1.363856 (受入線の切片)
=LN((1-0.1)/0.05)/(LN(0.05/0.01)-LN(0.95/0.99)) → 1.751018  (棄却線の切片)
できあがった2本が判定の境界です。
- 受入線:\( d = 0.024985\,n – 1.363856 \) これ以下になったら合格
- 棄却線:\( d = 0.024985\,n + 1.751018 \) これ以上になったら不合格
2本のあいだにいるあいだは検査を続けます。傾きが同じ平行線なので、帯の幅はずっと一定です。
判定表に直して現場で使う
直線のままでは現場で使いにくいので、累積不良数ごとに「何個目で判定がつくか」の表に直します。受入線・棄却線に \( d = 0, 1, 2, \ldots \) を代入して整数に丸めたものです。
| 累積不良数 | ここまでに達したら不合格 | ここまで検査したら合格 |
|---|---|---|
| 0個 | — | 55個 |
| 1個 | — | 95個 |
| 2個 | 9個目まで | 135個 |
| 3個 | 49個目まで | 175個 |
| 4個 | 90個目まで | 215個 |
| 5個 | 130個目まで | 255個 |
読み方は単純です。1個も不良が出なければ55個で合格。9個目までに2個目の不良が出たら、その場で不合格。3個目の不良が49個目までに出た場合も不合格です。
検算しておきます。55個すべて良品なら \( \Lambda = 55 \times (-0.041243) = -2.268363 \) で、受入境界 \( -2.251292 \) を下回ります。54個では \( -2.227120 \) でまだ届きません。表の55という数字はここから来ています。
不合格側も同じです。9個目で2個目の不良が出たとき \( \Lambda = 2 \times 1.609438 + 7 \times (-0.041243) = 2.930175 \) で、棄却境界 \( 2.890372 \) を超えます。ところが10個目だと \( 2.888932 \) となり、わずか0.0014足りずに判定がつきません。同じ「不良2個」でも、それが9個目までに出たか10個目に出たかで結論が変わります。良品1個あたり0.041243ずつ引かれていくためで、境界のすぐ近くではこうした紙一重の差が出ます。
Excelで判定欄を作るなら、累積不良数の列を用意して次の式を置きます。
=IF(C2>=0.024985*A2+1.751018,"不合格",IF(C2<=0.024985*A2-1.363856,"合格","継続"))
A列に検査個数、C列に累積不良数を入れておけば、1個入力するたびに判定が更新されます。
固定サンプル方式より何個減るか
比較相手を用意します。同じ条件(\( p_0 \) = 1%、\( p_1 \) = 5%、\( \alpha \) = 0.05、\( \beta \) = 0.10)を1回の抜取で満たす計数値抜取検査は、n = 132、合格判定個数 c = 3 です。二項分布で確かめられます。
=BINOM.DIST(3,132,0.01,TRUE)   → 0.955747  (不良率1%のロットが合格する確率)
=BINOM.DIST(3,132,0.05,TRUE)   → 0.099228  (不良率5%のロットが合格する確率)
合格確率0.955747は \( 1-\alpha \) の0.95以上、0.099228は \( \beta \) の0.10以下。条件を満たす最小のnがこの132です。二項分布の計算手順と同じ考え方です。
これに対して逐次検定の平均サンプル数(ASN)を、検査個数と累積不良数の全経路について確率を足し上げて求めました。
| 実際の不良率 | 逐次検定の平均サンプル数 | 固定方式132個との差 |
|---|---|---|
| 1%(合格にしたい) | 85.07個 | 35.6%少ない |
| 2.5%(中間) | 118.26個 | 10.4%少ない |
| 5%(不合格にしたい) | 71.05個 | 46.2%少ない |
良いロットで約36%、悪いロットで約46%減ります。破壊検査なら、そのまま廃棄する部品が減るということです。
ただし表の真ん中を見てください。不良率が \( p_0 \) と \( p_1 \) のちょうど中間にあるとき、削減はわずか10.4%まで落ちます。1%でも5%でもない中途半端なロットは、どちらの境界にもなかなか届かず、検査が長引きます。平均サンプル数が最大になるのはこの付近です。
使う前に知っておく3つの注意点
1. 運が悪いと固定方式より多くなる
平均が85個でも、個々のロットがそうなるとは限りません。判定表の「不良2個で合格するのは135個」を見てください。固定方式の132個を上回っています。不良が境界の帯の中をうろうろすると、検査個数はいくらでも伸びます。実務では上限個数を決めて打ち切り、そこで判定するのが普通です。
2. 教科書の平均サンプル数の式は楽観的に出る
ASNには次の近似式が広く載っています。
\[ \text{ASN} \approx \frac{L(p)\ln B + \{1-L(p)\}\ln A}{p\,a + (1-p)\,b} \]
\( L(p) \) は不良率 \( p \) のロットが合格する確率です。Excelでは分子・分母を素直に組むだけで計算できます。
=(0.95*LN(0.1/0.95)+0.05*LN(0.9/0.05))/(0.01*LN(5)+0.99*LN(0.95/0.99)) → 80.62
ところがこの式は不良率1%で80.62個、5%で57.55個を返します。厳密に計算した85.07個・71.05個より小さい値です。とくに不良率5%では19.0%も少なく見積もります。原因は、この近似が「境界をちょうど踏んで止まる」と仮定している点にあります。実際には不良が1個出ると \( \Lambda \) が1.609438も跳ねるため、境界を大きく飛び越して止まります。この行き過ぎの分だけ、実際のサンプル数は近似より増えます。近似値を検査計画の根拠にすると、必要数を少なく見込むことになります。
3. 実際の危険率は設定値とずれる
同じ計算から、不良率1%のロットが合格する確率は0.9710と出ました。設定した \( 1-\alpha = 0.95 \) より高く、実際の生産者危険は0.029です。Waldの境界は安全側に寄るように作られているためで、設計値どおりの5%にはなりません。消費者危険のほうは0.1006とほぼ設定どおりでした。統計的検出力を厳密に議論する場面では、この差を確かめてから使ってください。
よくある質問
Q. AQLの抜取表(JIS Z 9015)と逐次検定はどちらを使うべきですか?
A. 客先や社内規程で抜取表が指定されているなら、そちらに従ってください。逐次検定は検査個数が事前に確定しないため、取り決めの根拠として使いにくい方法です。逐次検定が向くのは、検査コストが高く、自分の裁量で止められる社内の試験です。抜取表の仕組みはAQLとJIS Z 9015で解説しています。
Q. 計量値(寸法や強度)でも逐次検定は使えますか?
A. 使えます。良品・不良の判定を尤度比に置き換える部分が変わるだけで、境界の考え方は同じです。正規分布を仮定して平均の差を見る形にすると、加算量は測定値そのものの一次式です。ただし分散を既知として扱う必要があり、現場で満たしにくい前提です。計量値なら計量値抜取検査のほうが実用的です。
Q. 管理図と役割が似ていませんか?
A. 似ています。CUSUM管理図は逐次確率比検定を工程の監視に応用したもので、累積した差が境界を超えたら異常と判定する構造は同じです。違いは止め方です。逐次検定はロットの合否を決めて終了しますが、管理図は判定後もリセットして監視を続けます。CUSUM管理図とEWMA管理図とあわせて読むと、両者のつながりが見えます。
Q. p0とp1はどう決めればよいですか?
A. 工程の実力と、客先が許す水準の2つから決めます。p0は通常運転で出ている不良率、p1は「これが出たら止める」水準です。注意したいのは両者を近づけすぎることで、たとえば1%と2%を見分けようとすると必要個数が跳ね上がります。今回は5倍の開きがあったので132個で済みました。判定の難しさとサンプル数の関係はサンプルサイズの決め方と同じ構造です。
まとめ
- 逐次検定は1個ずつ対数尤度比を足し、上下の境界を超えた時点で判定を打ち切る方法
- 加算量は不良で\( \ln(p_1/p_0) \)、良品で\( \ln\{(1-p_1)/(1-p_0)\} \)。境界は\( \alpha \)と\( \beta \)から決まる
- 累積不良数と検査個数の平行な2直線に直せば、現場では判定表として使える
- 不良率1%で平均85.07個、5%で71.05個。固定方式132個に対し35.6%・46.2%の削減。ただし中間の2.5%では118.26個まで伸び、削減は10.4%にとどまる
- 教科書の近似式は不良率5%で19.0%少なく出る。検査計画の根拠にはしない
まとめると、検査1個が高くつき自分の裁量で止められるなら逐次検定、個数を先に確定させて計画や取り決めに使うなら固定サンプル方式、という使い分けです。工程の不良率が \( p_0 \) と \( p_1 \) の中間に居座っている場合は、逐次検定にしても手間は減りません。
この記事の前提となる抜取検査の合格確率については抜取検査とOC曲線、検定そのものの組み立て方は仮説検定の考え方と手順で解説しています。あわせてご確認ください。