この記事でわかること
- 実施できない条件があるときの実験点の選び方(Excel対応)
- 情報行列の行列式で計画を比べる手順
- D効率の求め方と読み方
- 中心点を足すのが最善にならない理由
📌 前提知識:直交表の早見表と選び方を読んでいると理解しやすくなります
射出成形の条件出しで、成形温度と保圧時間の2因子を振ることになりました。各2水準なので4通り、直交表を持ち出すまでもない実験です。
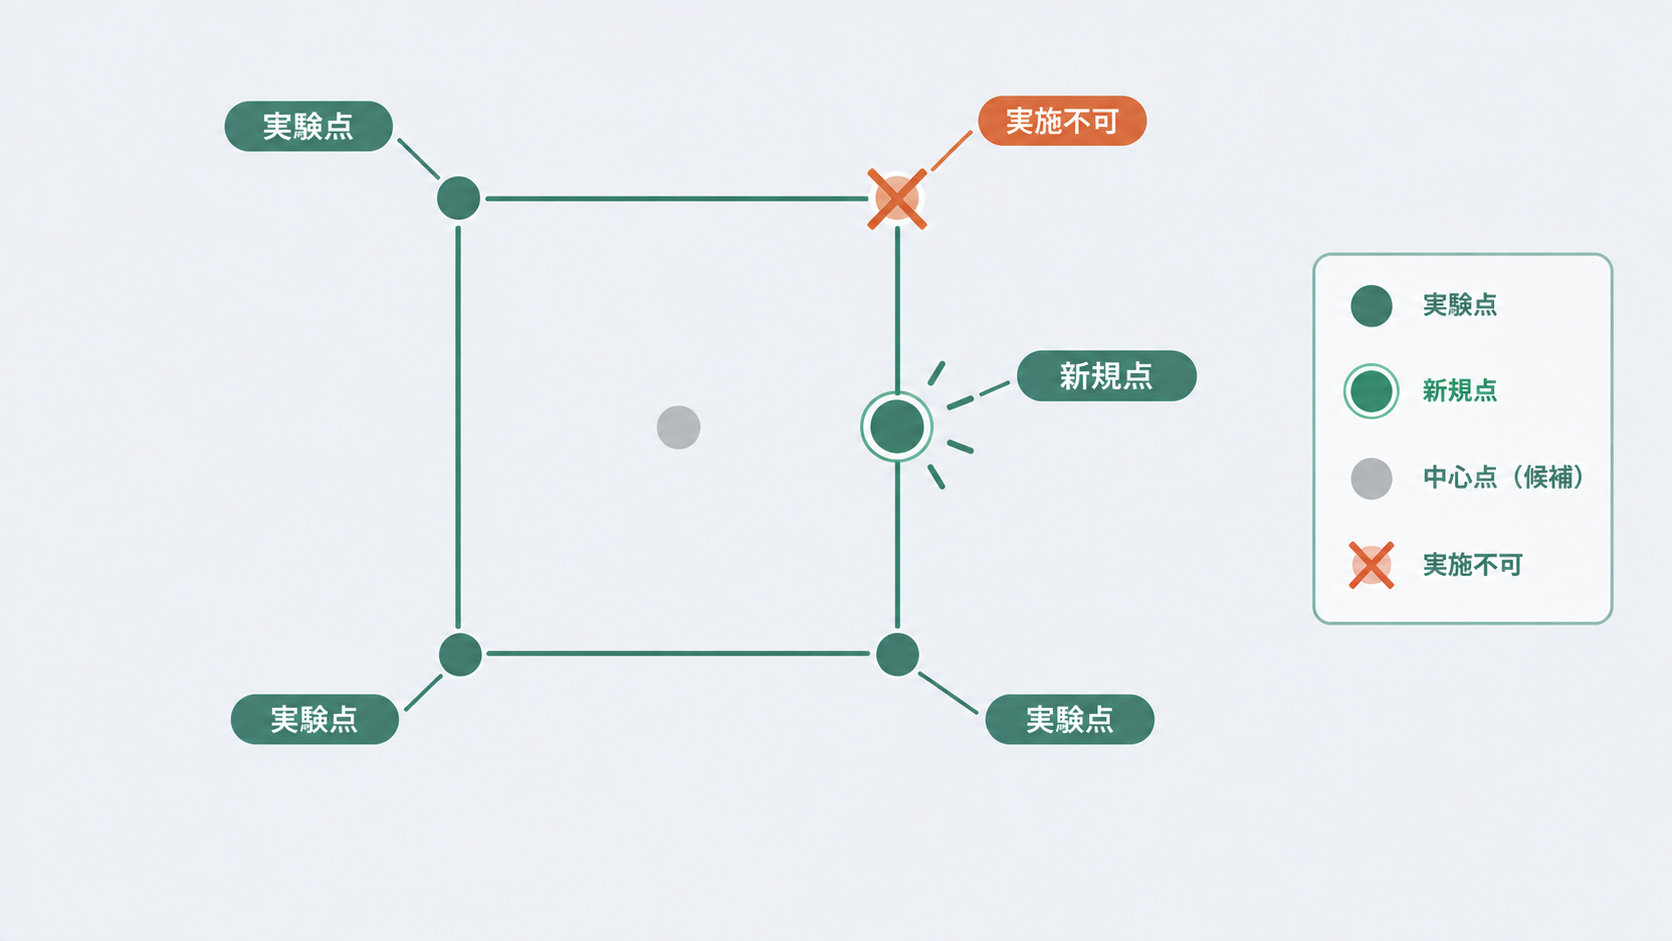
ところが技術検討で1つ止まりました。高温かつ長時間の条件は樹脂が熱分解して成形品が変色するため、実験そのものができません。4隅のうち1つが使えない状態です。
残り3点だけでも1次モデルの係数は求まります。ただ3点では自由度が残らず、誤差の見積もりができません。もう1点足すとして、どこを選ぶべきか。この「候補の中からどの実験点を選ぶか」を数値で決めるのがD最適計画です。
D最適計画を使う場面
D最適計画が必要になるのは、直交表や要因配置がそのまま当てはまらない実験です。次の3つが典型です。
- 実施できない条件があるとき。今回のような熱分解のほか、圧力と温度の組み合わせが装置の定格を超える場合などが該当します
- 実験回数を直交表より減らしたいとき。L8が組めても予算が6回分しかない、という場面で使えます
- 因子ごとに水準数がばらばらなとき。2水準と3水準と5水準が混在すると、混合水準直交表でも当てはまらないことがあります
逆に、制約がなく水準数も揃っているなら、D最適計画を持ち出す必要はありません。その条件では直交表がすでにD最適だからです。NG例(△)として、直交表が普通に組める実験にわざわざD最適を当てるのは手間が増えるだけです。実験計画法の基本どおりに直交表を選んでください。
Dは何の頭文字か
DはDeterminant(行列式)です。実験点を並べた計画行列を \( X \) とすると、\( X^{\mathsf{T}}X \) を情報行列と呼びます。D最適計画とは、この行列式 \( |X^{\mathsf{T}}X| \) が最大になる実験点の組み合わせを指します。
なぜ行列式なのかは、回帰係数の分散の式を見ると分かります。
\[ \mathrm{Var}(\hat{\boldsymbol{\beta}}) = \sigma^2 (X^{\mathsf{T}}X)^{-1} \]逆行列が入っているので、\( X^{\mathsf{T}}X \) が大きいほど係数の分散は小さくなります。行列式は逆行列の分母にあたる量で、これが小さいと係数の推定が一気に不安定になります。多重共線性で説明変数どうしが相関すると係数が暴れるのも、行列式がゼロに近づくのが原因です。同じ現象を、データを取る前の計画の段階で防ごうという発想です。
符号化した水準(下限を−1、上限を+1)で組む場合、行列式には上限があります。実験回数 \( n \)、推定する係数の数 \( p \) に対して \( |X^{\mathsf{T}}X| \le n^p \) で、等号が成り立つのは列どうしが直交しているときです。直交表が良い計画とされてきた理由は、この上限をちょうど達成しているからです。
例題|高温・長時間が実施できない2因子実験
成形温度を180℃と220℃、保圧時間を3秒と7秒で振ります。符号化すると次のとおりです。
| 符号 | 成形温度 x1 | 保圧時間 x2 |
|---|---|---|
| −1 | 180℃ | 3秒 |
| 0 | 200℃ | 5秒 |
| +1 | 220℃ | 7秒 |
当てはめるモデルは交互作用なしの1次式です。推定する係数は3つ。
\[ y = \beta_0 + \beta_1 x_1 + \beta_2 x_2 + \varepsilon \]完全実施なら4隅すべてを使います。このとき \( X^{\mathsf{T}}X \) は対角成分が4だけの行列になり、行列式は \( 4 \times 4 \times 4 = 64 \)。先ほどの上限 \( n^p = 4^3 = 64 \) と一致します。
ここから (+1, +1) すなわち220℃・7秒が抜けます。残る3点 (−1,−1)、(−1,+1)、(+1,−1) だけの行列式は16まで落ちます。因子と水準の組み方が崩れ、列の直交性が失われたためです。
4点目の候補を並べて、それぞれ行列式を計算します。
ExcelのMDETERMで候補を比べる
計算はExcelの行列関数だけで足ります。A列に定数項の1、B列に x1、C列に x2 を入れて、4行×3列の計画行列を作ります。たとえば4点目に220℃・5秒 (+1, 0) を選んだ場合は次のようになります。
       A    B    C
行1    1   -1   -1
行2    1   -1    1
行3    1    1   -1
行4    1    1    0
情報行列と行列式は1本の式で出せます。
=MDETERM(MMULT(TRANSPOSE(A1:C4),A1:C4)) → 40
MMULTとTRANSPOSEは配列を返すため、古いExcelではCtrl+Shift+Enterで確定してください。Microsoft 365では通常のEnterで動きます。
D効率は、完全実施の64を基準にして係数の数 \( p = 3 \) 乗根をとった値です。
\[ D_{\text{eff}} = \left( \frac{|X^{\mathsf{T}}X|}{n^p} \right)^{1/p} \]=(MDETERM(MMULT(TRANSPOSE(A1:C4),A1:C4))/4^3)^(1/3) → 0.855
候補をすべて計算した結果です。
| 4点目に選ぶ条件 | 行列式 | D効率 |
|---|---|---|
| 220℃・7秒(実施不可) | 64 | 100.0% |
| 220℃・5秒(右辺の中点) | 40 | 85.5% |
| 180℃・5秒(左辺の中点) | 24 | 72.1% |
| 200℃・5秒(中心点) | 24 | 72.1% |
| 既存3点のどれかを繰り返す | 32 | 79.4% |
200℃・7秒(上辺の中点)も220℃・5秒と同じ40になります。左右対称な位置なので当然の結果です。
中心点を足すのが最善にならない理由
実験の追加点というと、まず中心点が思い浮かびます。ところが今回の表では中心点が最下位でした。行列式24に対し、右辺の中点は40。1.67倍の差があります。既存点の繰り返し(32)にも負けています。
理由は、抜けた角が (+1, +1) だったことにあります。この穴のせいで x1 と x2 の列は「+1側の情報が足りない」状態です。中心点 (0, 0) はどちらの列にもゼロを足すだけなので、この偏りを何も直しません。一方の220℃・5秒 (+1, 0) は x1 の+1側を補うため、偏りが減ります。
係数の標準誤差で見ると差がはっきりします。\( (X^{\mathsf{T}}X)^{-1} \) の対角成分の平方根に \( \sigma \) を掛けたものが標準誤差です。
=SQRT(INDEX(MINVERSE(MMULT(TRANSPOSE(A1:C4),A1:C4)),2,2)) → 0.5244 (温度の係数)
| 4点目 | 温度の係数の標準誤差 | 保圧時間の係数 |
|---|---|---|
| 220℃・5秒 | 0.5244σ | 0.6325σ |
| 200℃・5秒(中心点) | 0.6770σ | 0.6770σ |
| 完全実施(参考) | 0.5000σ | 0.5000σ |
中心点を選ぶと、温度の係数の標準誤差が29.1%大きくなります。同じ4回の実験で、同じ費用をかけて、温度の効果だけ判定が鈍るということです。回帰係数の読み方で扱った係数の有意性は、この標準誤差で割って判定します。分母が3割膨らめば結論が変わる場面が出てきます。
ただし、これは1次モデルを当てはめると決めた場合の話です。曲がり(2次項)まで見たいなら、中心点がないとそもそも推定できません。D最適の答えはモデルの形に依存します。この点は後述します。
使う前に知っておく限界
1. モデルを先に決めないと計算できない
D最適は「このモデルを推定するのに最適」という意味です。1次モデルなら角に寄せるのが有利、2次モデルなら中心や中間水準が要る、と答えが変わります。直交表のように「とりあえず組んでおく」使い方はできません。曲がりを見るつもりなら応答曲面法の計画から入るほうが素直です。
2. 候補が増えると総当たりできない
今回は候補が9通りだったので全部計算できました。実務では因子が5つ、候補点が数百、選ぶ実験回数が12といった規模になり、組み合わせが天文学的に増えます。そこでは交換アルゴリズム(点を1つずつ入れ替えて行列式が増えるか試す手順)で近似解を探します。Excelの関数だけでは回せません。Excel統計の限界で触れたとおり、ここは専用ソフトの領域です。
3. 効率が上がっても無作為化は省略できない
D最適は実験点の配置だけを決めます。実施順序をどうするか、ブロックをどう切るかは別の問題です。効率よく点を選んでも、温度の低い条件から順に実施すれば、時間とともに変わる要因が温度の効果に紛れ込みます。フィッシャーの三原則の無作為化と局所管理は、計画の種類にかかわらず必要です。
よくある質問
Q. D最適のほかにA最適やG最適も見かけます。何が違いますか?
A. 何を小さくしたいかが違います。Dは係数の同時信頼領域の体積、Aは係数の分散の合計、Gは予測値の分散の最大値を基準にします。実務でよく使われるのはDで、行列式1つで比較できて計算が軽いからです。予測の精度を全域で保証したい場合はGが向きますが、計算が重くなります。まずDで選び、必要なら他の基準で確かめる進め方が現実的です。
Q. 実験回数を増やせばD効率は100%に近づきますか?
A. 近づくとは限りません。D効率は実験回数nで正規化してあるので、回数を増やしただけでは上がりません。今回の例で5回に増やしても、実施できない角が使えない事実は変わらないため、100%には届きません。回数を増やして改善するのは行列式の絶対値であって、1回あたりの効率ではありません。
Q. 直交表の一部の行が実施できない場合、その行を削るだけで済みますか?
A. 済みません。行を削った時点で列の直交性が崩れ、効果が互いに混ざります。今回の例でも4点から3点に減っただけで行列式は64から16へ、4分の1に落ちました。削った後にどの点を足すかまで含めて計画し直してください。割り付けの考え方は直交表の割り付け方で解説しています。
Q. 求めた計画のデータは、普通の重回帰で解析してよいですか?
A. かまいません。D最適で決まるのは実験点の配置だけで、解析は通常の最小二乗法です。分散分析表の形にもできます。ただし直交していないため、因子を1つ外すと残りの係数が動きます。重回帰分析と同じく、変数選択の順序で結果が変わる点に注意してください。
📚 この記事の内容をもっと深く学ぶ
まとめ
- D最適計画は、情報行列 \( X^{\mathsf{T}}X \) の行列式が最大になる実験点を選ぶ方法
- 符号化した計画では \( |X^{\mathsf{T}}X| \le n^p \) が上限で、等号を満たすのが直交表
- 4隅のうち1点が実施できない例では、3点だけだと行列式が64から16へ落ちる。4点目は右辺の中点が行列式40・D効率85.5%で最善、中心点は24・72.1%で最下位
- 中心点を選ぶと温度の係数の標準誤差が29.1%大きくなる
- 答えはモデルの形に依存する。2次項を見るなら中心点は必須
まとめると、制約がなく水準が揃っているなら直交表、実施できない条件や半端な実験回数があるならD最適計画、という使い分けです。そして候補点が数十を超えたらExcelでは手に負えないので、専用ソフトに任せてください。
この記事の前提となる直交表の選び方は直交表の早見表、実験回数を減らす別の方法は一部実施要因配置実験で解説しています。あわせてご確認ください。