この記事でわかること
- 共変量で調整してから群を比べる手順(Excel対応)
- 調整後の平均(修正平均)の求め方
- Excelのダミー変数回帰で共分散分析を実行する方法
- 使う前に確かめる平行性の条件
📌 前提知識:一元配置分散分析の手順を読んでいると理解しやすくなります
熱処理条件を3つ比べる実験をしました。各条件5個ずつ、処理後の硬度を測定して一元配置分散分析にかけたところ、p値は0.99。条件による差はまったく検出できません。
報告書に「3条件に有意差なし」と書こうとして、データを眺め直しました。素材の初期硬度が条件ごとに大きく違います。条件1には硬い素材、条件3には軟らかい素材が偏って割り当てられていました。
この状態で処理後の硬度だけを比べても、条件の効果は素材のばらつきに埋もれます。共分散分析は、この「もともとの違い」を差し引いてから群を比べる手法です。
共分散分析を使う場面
共分散分析(ANCOVA)が効くのは、群の比較に邪魔な連続量が混ざっているときです。次の3つがあてはまります。
- 処理前の値がばらついているとき。初期硬度、素材ロット、投入時の寸法などが該当します
- 無作為化できずに群の条件が偏ったとき。過去データを後から分析する場合によく起こります
- 検出力を上げたいとき。誤差に埋もれていた効果が、共変量を除くと見えてきます
共変量に選んでよいのは処理の影響を受けない値だけです。NG例(△)として、処理後に測った別の特性を共変量にするのは避けてください。処理の効果そのものを共変量が吸い取ってしまい、条件の差が消えます。時間の前後で言えば、共変量は必ず処理より前に確定している量です。
共変量で調整するとはどういうことか
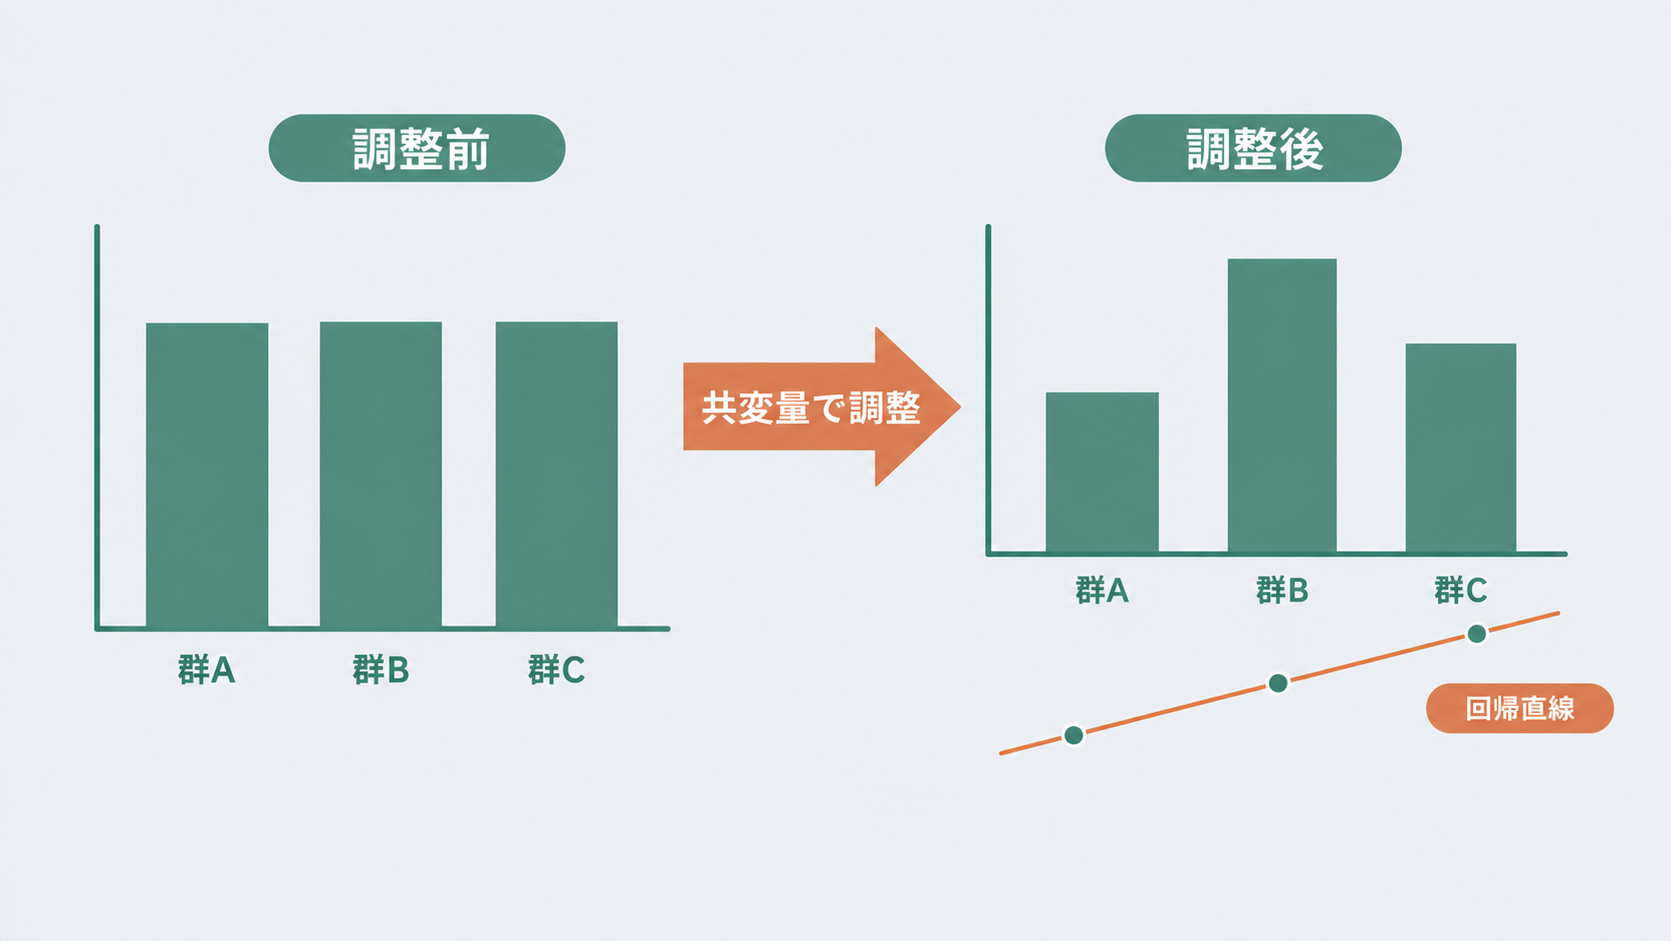
一元配置分散分析は、群ごとの平均を比べます。共分散分析は、共変量が全体平均だったら各群はいくつになるかを計算してから比べます。この値を調整後平均(修正平均)と呼びます。
\[ \bar{y}_{i(\text{adj})} = \bar{y}_i – b(\bar{x}_i – \bar{x}) \]
\( \bar{y}_i \) は群iの平均、\( \bar{x}_i \) は群iの共変量平均、\( \bar{x} \) は全体の共変量平均、\( b \) は群内でプールした回帰係数です。Excelでは引き算1回で求まります。
=D2-$B$20*(C2-$C$20) ← D2に群平均、C2に群の共変量平均、B20に傾き、C20に全体平均
考え方は回帰分析に近く、検定の形は分散分析です。両者のあいだに位置する手法だと捉えると理解しやすくなります。相関分析と回帰分析の違いで扱っている「説明する」という発想を、群の比較に持ち込んだ形です。
例題|3つの熱処理条件と素材の初期硬度
熱処理条件A・B・Cで、それぞれ5個ずつ処理しました。xが処理前の初期硬度、yが処理後の硬度です(いずれもHV)。
| 条件A(x / y) | 条件B(x / y) | 条件C(x / y) |
|---|---|---|
| 156 / 165.2 | 148.5 / 164.5 | 141 / 165.0 |
| 158 / 165.8 | 150.5 / 166.9 | 143 / 165.9 |
| 160 / 168.3 | 152.5 / 167.6 | 145 / 168.6 |
| 162 / 169.4 | 154.5 / 169.8 | 147 / 169.5 |
| 164 / 170.8 | 156.5 / 171.7 | 149 / 171.0 |
まず普通に一元配置分散分析をかけます。
| 条件 | 初期硬度の平均 | 処理後硬度の平均 |
|---|---|---|
| A | 160.0 | 167.9 |
| B | 152.5 | 168.1 |
| C | 145.0 | 168.0 |
処理後硬度の平均は167.9・168.1・168.0。ほとんど同じです。分散分析表は次のとおりです。
| 要因 | 平方和 | 自由度 | F値 |
|---|---|---|---|
| 条件 | 0.10 | 2 | 0.0077 |
| 誤差 | 78.04 | 12 | — |
F値0.0077に対するp値は0.9923です。Excelでは次の式で求まります。
=F.DIST.RT(0.0077, 2, 12) → 0.9923
「3条件に差はない」という結論です。Excelで分散分析を行う手順のとおりに操作しても同じ表が出ます。
⭐ 調整すると結論がひっくり返る
ここで初期硬度を見てください。条件Aには平均160の硬い素材、条件Cには平均145の軟らかい素材が入っています。15も違う素材を同じ土俵で比べていたわけです。
群内でプールした回帰係数を求めます。各群の中で、初期硬度が1上がると処理後硬度がいくつ上がるかという値です。
\[ b = \frac{\sum_i \sum_j (x_{ij} – \bar{x}_i)(y_{ij} – \bar{y}_i)}{\sum_i \sum_j (x_{ij} – \bar{x}_i)^2} = 0.7950 \]
Excelでは、各群で偏差を取った列を作ってからSLOPE関数にかけるか、次の形で直接計算できます。
=SUMPRODUCT(C2:C16-E2:E16, D2:D16-F2:F16)/SUMPRODUCT((C2:C16-E2:E16)^2)  → 0.7950
  (C列に初期硬度、D列に処理後硬度、E・F列にそれぞれの群平均)
全体の初期硬度平均は152.5です。調整後平均を計算します。
| 条件 | 生の平均 | 調整量 | 調整後平均 |
|---|---|---|---|
| A | 167.9 | −0.795×(160−152.5) | 161.94 |
| B | 168.1 | −0.795×(152.5−152.5) | 168.10 |
| C | 168.0 | −0.795×(145−152.5) | 173.96 |
161.9・168.1・174.0。条件Cが条件Aより12も高いという結果に変わりました。検定します。
\[ F = \frac{(SS_{\text{縮約}} – SS_{\text{フル}})/2}{SS_{\text{フル}}/(N-4)} = \frac{(65.8327 – 2.1970)/2}{2.1970/11} = 159.31 \]
=F.DIST.RT(159.31, 2, 11) → 7.56E-09
p値は0.0000000076。先ほどのp=0.99とは正反対の結論です。
⭐ここが共分散分析の勘所です。誤差平方和が78.04から2.20へ、97%も減っています。「誤差」と呼んでいたもののほとんどが、実は素材の初期硬度で説明できるばらつきでした。それを取り除いたことで、条件の効果が誤差の陰から出てきた形です。
このデータで無作為化ができていれば、初期硬度は3群に均等に散ったはずで、こんなことは起きません。フィッシャーの三原則の無作為化が守れない場面の保険として共分散分析がある、と考えてください。
Excelで計算する|ダミー変数の回帰
Excelに共分散分析のメニューはありませんが、ダミー変数を使った回帰分析で同じ結果が出せます。分析ツールの回帰分析をそのまま使えます。
条件が3つなら、ダミー変数は2本です。条件Aを基準にして次のように置きます。
| 条件 | d1 | d2 |
|---|---|---|
| A(基準) | 0 | 0 |
| B | 1 | 0 |
| C | 0 | 1 |
3本目を作らないのが要点です。3本すべて入れると列が完全に重なって計算できません。理由はダミー変数の作り方で解説しています。
あとは分析ツールで、入力Y範囲に処理後硬度、入力X範囲に「初期硬度・d1・d2」の3列を指定するだけです。
入力Y範囲: D2:D16   (処理後硬度)
入力X範囲: C2:E16   (初期硬度・d1・d2)
出力される係数表のうち、初期硬度の係数が先ほどの0.7950、d1とd2の係数が条件Aに対する調整後の差です。それぞれのp値がそのまま各条件とAの比較を表します。操作手順はエクセル分析ツールを使った回帰分析と同じです。
説明変数が3つになるので、重回帰分析の読み方がそのまま使えます。係数の意味の取り方は回帰係数の見方を参照してください。
使う前に確かめる条件
共分散分析には、分散分析の前提に加えてもう1つ条件があります。群ごとの回帰の傾きが揃っていること(平行性)です。
群ごとに傾きが違うなら、「共変量がいくつのときの比較か」で答えが変わります。1本の調整量で済ませられません。今回のデータで群別の傾きを出すと次のとおりです。
| 条件 | 傾き |
|---|---|
| A | 0.740 |
| B | 0.865 |
| C | 0.780 |
この差が偶然かを検定します。傾きを群ごとに分けたモデルと、1本に揃えたモデルの残差を比べる形です。
\[ F = \frac{(2.1970 – 1.8710)/2}{1.8710/9} = 0.784 \]
=F.DIST.RT(0.784, 2, 9) → 0.485
p=0.485で、傾きに差があるとは言えません。平行性の条件は満たしています。
ダミー変数の回帰で確かめるなら、初期硬度×d1、初期硬度×d2という交互作用の列を足して、その2つが有意でないことを見ます。交互作用と同じ考え方です。もし有意なら共分散分析は使わず、共変量の水準ごとに層別して比べてください。
正規性と等分散は一元配置分散分析と同じ前提です。確認手順は分散分析の前提条件にまとめています。
よくある質問
Q. 共変量は何個まで入れられますか?
A. 複数入れても計算はできますが、2〜3個までが現実的です。入れるほど自由度が減り、共変量どうしが相関していると係数が不安定です。判断の目安は多重共線性の確認と同じで、VIFが10を超える組み合わせは避けてください。迷ったら、処理前に測った値のうち目的変数との相関がいちばん強い1つに絞るのが安全です。
Q. 事前に群の共変量平均を揃えておけば共分散分析は不要ですか?
A. 不要になるわけではありません。平均が揃っていても、共変量が目的変数を説明する分だけ誤差平方和を減らせるので、検出力は上がります。今回の例では誤差が78.04から2.20まで下がりました。群の偏りを直す目的と、誤差を減らす目的の2つがあると考えてください。
Q. 共変量が処理の影響を受けているかどうかは、どう判断しますか?
A. 測定の時点で決めます。処理より前に測った値なら影響を受けません。判断に迷うのは同時期に測った値です。念のため共変量を目的変数にして群間で分散分析をかけ、群による差が出るなら処理の影響を疑ってください。差が出た共変量をそのまま使うと、条件の効果まで一緒に差し引いてしまいます。
まとめ
- 共分散分析は、共変量が全体平均だったら各群はいくつかを計算してから比べる手法
- 調整後平均は「群平均 − 傾き×(群の共変量平均 − 全体平均)」で求める
- 今回の例では生の平均167.9・168.1・168.0でp=0.99だったものが、調整後161.9・168.1・174.0でp=0.0000000076になった
- 誤差平方和が78.04から2.20へ減っており、誤差の大半は素材のばらつきだった
- Excelではダミー変数を使った回帰分析で同じ結果が出せる。使う前に平行性を確かめる
まとめると、群の条件が偏っていない実験なら一元配置分散分析、処理前の値がばらついているなら共分散分析、という使い分けです。そして無作為化ができた実験では、まず無作為化を信じてください。共分散分析は、それができなかったときの後処理です。
この記事の前提となる分散分析の手順は一元配置分散分析、同じ対象を繰り返し測った場合の扱いは繰り返し測定分散分析で解説しています。あわせてご確認ください。