この記事でわかること
- statsmodelsで単回帰・重回帰を当てはめる手順
- summary出力のうち実務で見るべき4か所
- 説明変数を増やすかどうかの判断基準
- 作った式で予測するときの注意点
📌 前提知識:Python統計解析入門|Excelとの使い分けと学び方を読んでいるとライブラリの役割分担がつかめます
成形条件を変えたときに製品の強度がどう動くかを、条件表と測定値の一覧から読み取ろうとして手が止まった。温度を上げれば強度が上がるのは見当がつくものの、「10℃上げたら何MPa上がるのか」まで言えないと、条件出しの判断につながりません。
ここで使うのが回帰分析です。この記事では、射出成形の測定データを題材に、Pythonで単回帰から重回帰までを実行し、出力のどこを見て判断するかを順に解説します。ExcelのSLOPE関数やLINEST関数との対応も示すので、普段Excelで回帰をしている方も置き換えながら読めます。
回帰分析をPythonで行う場面
回帰分析は、結果(目的変数)が原因(説明変数)によってどれだけ動くかを式で表す手法です。次の条件がそろっているときに使います。
- 目的変数が量で測れる:強度、収率、寸法、粘度など。合否のような2値ではない
- 説明変数の水準に幅がある:温度が全部同じでは、温度の効果は測れません
- 関係の向きが決まっている:温度が強度を動かす、という因果の方向が説明できる
ExcelではなくPythonを選ぶ理由は、主に反復と拡張です。毎月同じ集計をするなら一度書けば使い回せますし、説明変数が増えても式を書き換えるだけで済みます。ツールの選び分けはExcel統計の限界はどこか|統計ソフト4種の比較と選び方で整理しています。
NG例(△): 関係の向きが逆、または相互に影響し合う変数を入れる使い方です。強度から温度を予測する式を作っても、条件出しには使えません。どちらが原因か決められない場合は、まず相関分析と回帰分析の使い分け|違いと判断基準をExcelで解説で相関にとどめるか回帰へ進むかを判断します。
もうひとつのNG例が、データの範囲外を予測することです。210〜270℃で採ったデータから作った式に300℃を入れても、その温度で同じ関係が続く保証はありません。式が使えるのは、あくまでデータを採った範囲の中です。
題材のデータと準備
射出成形で、樹脂温度と保圧を変えながら引張強度を測った12条件のデータを使います。
| 樹脂温度 x₁(℃) | 保圧 x₂(MPa) | 引張強度 y(MPa) |
|---|---|---|
| 215 | 45 | 55.6 |
| 220 | 60 | 56.5 |
| 225 | 50 | 57.2 |
| 230 | 70 | 61.6 |
| 235 | 55 | 58.0 |
| 240 | 75 | 63.0 |
| 245 | 50 | 58.0 |
| 250 | 65 | 63.0 |
| 255 | 80 | 64.6 |
| 260 | 60 | 63.9 |
| 265 | 85 | 66.3 |
| 270 | 70 | 65.9 |
使うライブラリはpandasとstatsmodelsの2つです。statsmodelsは統計の出力表を作るためのライブラリで、回帰分析ではこちらを使います。
import pandas as pd
import statsmodels.api as sm

df = pd.DataFrame({
    "temp":     [215, 220, 225, 230, 235, 240, 245, 250, 255, 260, 265, 270],
    "pressure": [45, 60, 50, 70, 55, 75, 50, 65, 80, 60, 85, 70],
    "strength": [55.6, 56.5, 57.2, 61.6, 58.0, 63.0, 58.0, 63.0, 64.6, 63.9, 66.3, 65.9],
})機械学習で使うscikit-learnでも回帰は計算できますが、係数の検定結果や決定係数がまとめて出るのはstatsmodelsです。要因の効果を読み取るのが目的なら、statsmodelsのほうが実務に向きます。
単回帰|樹脂温度だけで当てはめる
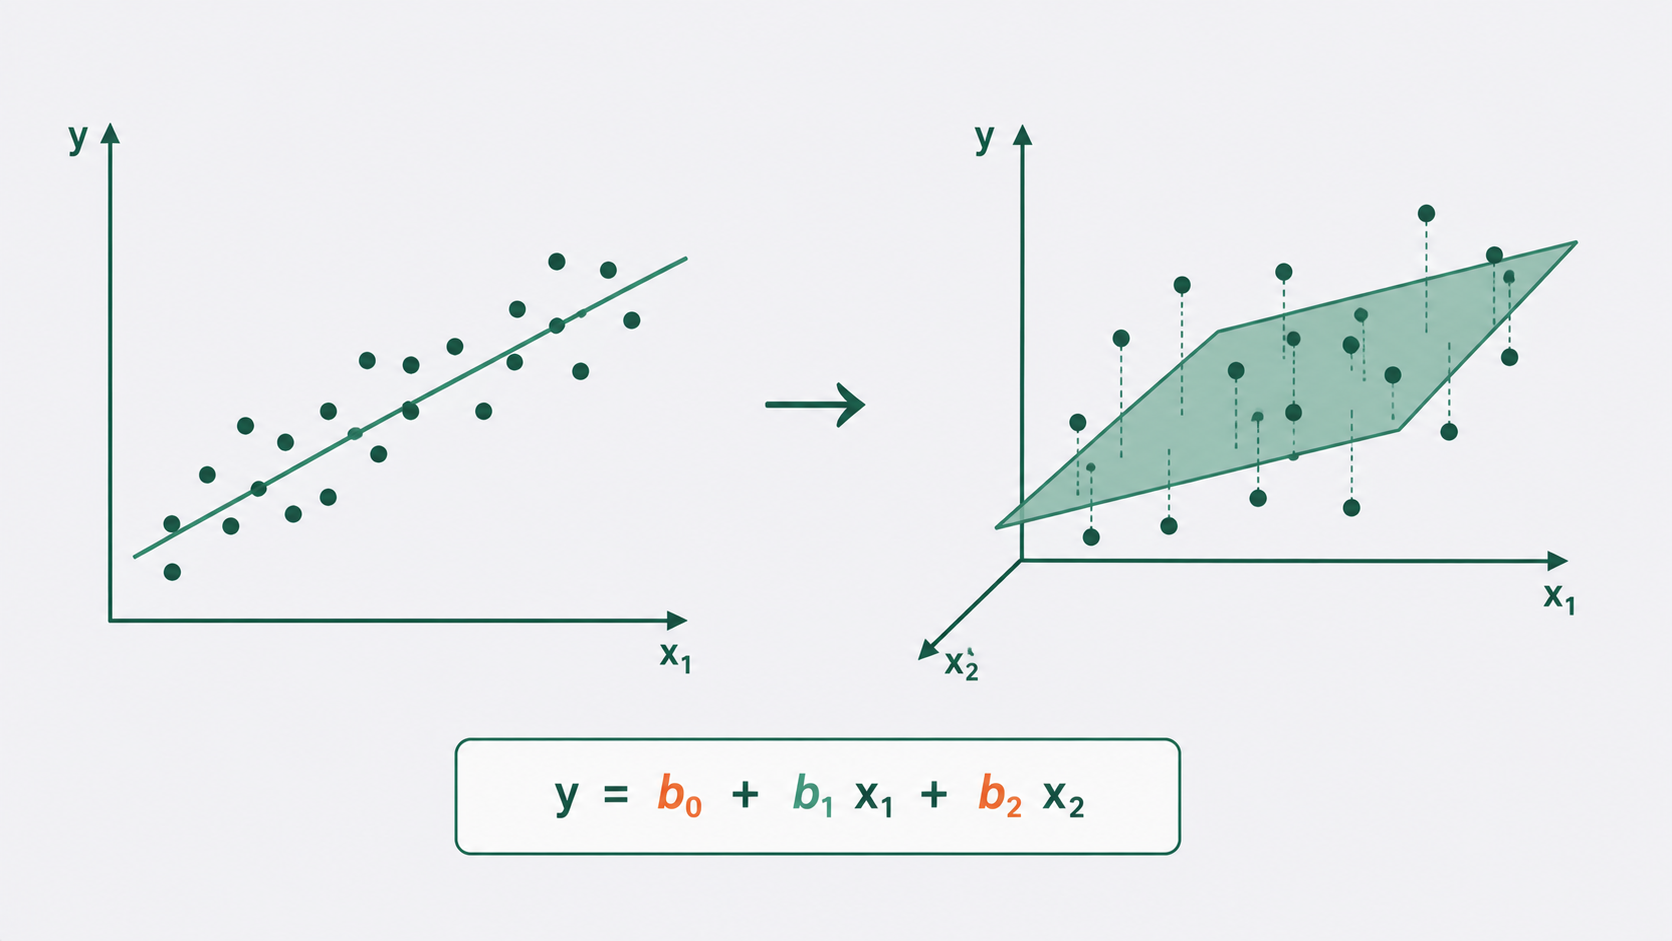
まず説明変数を樹脂温度1つに絞ります。単回帰の式は次の形です。
\[ y = b_0 + b_1 x_1 \]
\( b_1 \) は傾きで、x₁が1単位増えたときにyがいくつ増えるかを表します。\( b_0 \) は切片です。傾きは次の式で求まります。
\[ b_1 = \frac{\sum (x_i – \bar{x})(y_i – \bar{y})}{\sum (x_i – \bar{x})^2} \]
Excelでは SLOPE関数と INTERCEPT関数が対応します。
=SLOPE(C2:C13, A2:A13)       ← 傾き b₁
=INTERCEPT(C2:C13, A2:A13)   ← 切片 b₀
=RSQ(C2:C13, A2:A13) ← 決定係数 R²Pythonでは次のように書きます。add_constant を忘れると切片なしの式になるため、ここが最初のつまずきどころです。
X = sm.add_constant(df[["temp"]])   # 切片の列を追加
model = sm.OLS(df["strength"], X).fit()
print(model.summary())
実行すると、次の値が得られます。
- 傾き b₁ = 0.1912(樹脂温度1℃あたり0.19MPa)
- 切片 b₀ = 14.770
- 決定係数 R² = 0.799
- 残差標準誤差 = 1.811 MPa
式にすると \( y = 14.770 + 0.1912 x_1 \) です。樹脂温度を10℃上げると強度が約1.9MPa上がると読めます。条件出しの会話に持ち込めるのは、この形にしてからです。
summary出力の読み方
statsmodelsのsummaryは項目が多く、初見では圧倒されます。実務で見るのは次の4か所です。
| 見る場所 | 何が分かるか | 今回の値 |
|---|---|---|
| coef | 係数。1単位あたりの変化量 | temp = 0.1912 |
| P>|t| | その変数の効果が偶然かどうか | 0.001未満 |
| R-squared | ばらつきの何割を説明できたか | 0.799 |
| Adj. R-squared | 変数の数を考慮した決定係数 | 0.779 |
coefは単位とセットで読む
0.1912という数字だけでは大きいのか小さいのか判断できません。単位を付けて「1℃あたり0.19MPa」と読むのが実務の読み方です。実際の運転幅が20℃あるなら、その範囲で約3.8MPa動く計算です。
係数どうしの重要度を比べたいときは、単位の影響を取り除いた標準化係数を使います。考え方は回帰係数の読み方|偏回帰係数と標準化係数で扱っています。
R²は「説明できた割合」で、正しさではない
R² = 0.799は、強度のばらつきの約80%を樹脂温度で説明できたという意味です。残り20%は他の要因か測定のばらつきです。
気をつけたいのは、R²が高いことと式が妥当であることは別という点です。説明変数を増やせばR²は必ず上がるため、変数の数を考慮したAdj. R-squaredのほうを比較に使います。決定係数そのものの性質は決定係数(R²)の求め方と解釈|ExcelのRSQ関数と調整済みR²の使い分けで詳しく扱っています。
残差の確認は別工程
summaryの数値がよくても、残差に偏りがあれば式は使えません。直線で当てはめてよいか、ばらつきが一定か、といった前提の確認は回帰分析の前提条件と残差分析|ExcelとPythonで確認する方法で手順をまとめています。係数を読む前に残差を見るのが本来の順序です。
重回帰|保圧を加える
残り20%の中に、保圧の効果が入っていそうです。説明変数を2つに増やします。
\[ y = b_0 + b_1 x_1 + b_2 x_2 \]
Excelでは LINEST関数が対応します。説明変数の列を隣り合わせに並べ、配列数式として入力します。
=LINEST(C2:C13, A2:B13, TRUE, TRUE)Pythonは、渡す列を増やすだけです。
X2 = sm.add_constant(df[["temp", "pressure"]])
model2 = sm.OLS(df["strength"], X2).fit()
print(model2.summary())
結果は次のとおりです。
| 項目 | 単回帰(温度のみ) | 重回帰(温度+保圧) |
|---|---|---|
| 切片 b₀ | 14.770 | 21.018 |
| 温度の係数 b₁ | 0.1912 | 0.1265 |
| 保圧の係数 b₂ | — | 0.1479 |
| R² | 0.799 | 0.943 |
| Adj. R² | 0.779 | 0.930 |
| 残差標準誤差 | 1.811 | 1.017 |
Adj. R²が0.779から0.930へ上がり、残差標準誤差が1.811から1.017MPaへ縮みました。予測の外れ幅がおよそ半分になったということです。保圧を入れた価値があったと判断できます。
温度の係数が小さくなった理由
見落としやすいのがここです。温度の係数が0.1912から0.1265へ下がりました。温度の効果が弱まったわけではありません。
単回帰の0.1912には、温度と一緒に動いていた保圧の効果が混ざっていました。保圧を式に入れたことで分離され、温度だけの効果が0.1265として残ったという意味です。重回帰の係数は「他の変数を固定したときの効果」を表すため、単回帰と値が変わるのが普通です。
この混ざり具合が強すぎると係数が不安定になります。今回は温度と保圧の相関がr = 0.62、VIFは1.64で、目安の10を大きく下回るため問題ありません。診断の手順は多重共線性(VIF)とは|重回帰分析の問題を診断・解消する手順にまとめています。
なお、材料ロットや金型のように数値でない条件を式に入れたい場合は、0と1に変換して説明変数にします。方法はダミー変数の使い方|質的データを回帰に入れるで扱っています。
作った式で予測する
得られた式は \( y = 21.018 + 0.1265 x_1 + 0.1479 x_2 \) です。樹脂温度245℃・保圧70MPaのときの強度を計算します。
new = pd.DataFrame({"const": [1], "temp": [245], "pressure": [70]})
print(model2.predict(new))     # → 62.37
手計算でも確かめられます。21.0178 + 0.12654×245 + 0.14792×70 = 62.37MPaです。Pythonの出力と手計算が一致するかは毎回見ておくと、列の順番違いなどの取り違えに気づけます。
このとき、表示用に丸めた係数で検算すると値がずれます。上の表の4桁(0.1265・0.1479)で同じ計算をすると62.36となり、Pythonの62.37と0.01違います。誤りではなく丸めの影響です。手計算で突き合わせるときは、model2.params で桁を落とす前の係数を出してから使ってください。
ただし62.37という1点の数字をそのまま信じるのは危険です。残差標準誤差が1.017MPaある以上、実際の値はその前後にばらつきます。幅を付けて示す方法は回帰分析の予測区間|信頼区間との違いとExcelでの計算手順で解説しています。
よくあるつまずき
- add_constantを忘れる:切片なしの式になり、係数も決定係数も別物の値が出ます。エラーは出ないため気づきにくい代表例です
- 説明変数を入れすぎる:データ12件に対して変数を5個も6個も入れると、そのデータにだけよく合う式ができます。目安は1変数あたり10件以上です
- 単位を混ぜる:同じ列にmmとcmが混在していると、係数が意味を持ちません。集計前に単位をそろえます
- 欠測をそのままにする:statsmodelsは既定で欠測を含む行を除きます。何行使われたかはsummaryのNo. Observationsで確認します
生成AIにコードを書かせる場合も、この4点は変わりません。返ってきたコードを既知の値と突き合わせる手順はAIにPythonコードを書かせる|統計解析での検証手順にまとめています。この記事の数値をそのまま答え合わせに使えます。
よくある質問(FAQ)
Q. scikit-learnとstatsmodelsのどちらを使えばよいですか?
要因の効果を読み取るのが目的ならstatsmodelsです。係数の検定結果や決定係数がsummaryにまとまって出ます。scikit-learnは予測精度を上げることに向いた作りで、係数の検定は標準では出ません。品質管理の場面では前者を使う場面がほとんどです。
Q. R²がどれくらいあれば使える式といえますか?
一律の基準はありません。同じ0.8でも、条件を管理できる実験データなら物足りず、現場の実測データなら十分という判断です。R²の絶対値より、残差標準誤差が実務で許せる幅に収まっているかで見るほうが判断しやすくなります。今回なら予測の外れがおよそ±1MPaという読み方です。
Q. 説明変数はどこまで増やしてよいですか?
Adj. R²が上がらなくなったら止めます。R²は変数を増やせば必ず上がりますが、Adj. R²は効果の薄い変数を入れると下がります。変数選択の考え方は重回帰分析の結果の読み方と変数選択で扱っています。
Q. Excelの分析ツールで出した結果と数値が合いません
まず、使っている行数と列の対応を確認してください。次に多いのが切片の扱いで、Excel側で「定数に0を使用」にチェックが入っていると切片なしの計算です。Excel側の手順は回帰分析のやり方と結果の見方で確認できます。
📚 この記事の内容をもっと深く学ぶ
まとめ
- statsmodelsの
sm.OLSで当てはめる。add_constantを忘れると切片なしの別物になる - summaryで見るのはcoef・P>|t|・R-squared・Adj. R-squaredの4か所
- 係数は単位とセットで読む。今回は樹脂温度1℃あたり0.13MPa、保圧1MPaあたり0.15MPa
- 変数を増やすかどうかはAdj. R²と残差標準誤差で判断する(今回は1.811→1.017MPaに改善)
- 重回帰で係数が変わるのは正常。他の変数を固定したときの効果に変わるため
1つの要因で説明がつくなら単回帰、複数の条件が絡むなら重回帰、という使い分けです。関係の強さだけを見たい段階ならPythonで相関分析|相関係数と散布図の求め方が先です。式を作った後は回帰分析の前提条件と残差分析|ExcelとPythonで確認する方法で前提を確認してください。なお、相関分析と単回帰分析はQC検定2級の手法編に含まれる出題分野です。試験対策も兼ねて体系的に学びたい方はQC検定2級 手法編の攻略ロードマップを参照してください。回帰分析を体系的に学び直したい方には、レベル別のおすすめ書籍を統計学・実験計画法のおすすめ本まとめで紹介しています。